📝 상세 정리
1. Kafka는 왜 필요할까?
일단 이와 같은 서비스를 운영하고 있다고 생각해보자.
거래 발생 -> DB 저장 -> 이메일 서비스 호출 -> 이상거래 탐지 서비스 호출 -> 통계 서비스 호출
이런식으로 한 트랜잭션에 대해, 그 결과를 필요로 하는 시스템이 덕지덕지 붙어있다고 생각해보자. 여기서 다음과 같은 이슈들이 발생하면 어떻게 될까?
- 이메일 서비스가 조금 느리다면?
- 이상거래 탐지 서비스가 30초동안 죽어있는다면?
- 통계 서비스에서 버그가 발견되어서 어제 발생한 모든 거래를 다시 처리하고싶다면?
첫번째 질문에 대해선 당연히 병렬화를 기대할 수 있겠다. 저렇게 직렬적으로 꽂는게 아니라, 거래가 DB저장을 성공적으로 수행한다면, 나머지 서비스 시스템들을 다 비동기로 실행하면 더 좋겠다.
- 그런데 거래 API가 호출한 직후 죽거나, 한 서비스가 오랫동안 응답하지 않는다면?
- 누가 어떤 작업까지 성공적으로 수행했는지를 어떻게 확인하지?
- 또한, 어떤 서비스 하나가 실패했다고 해서 DB 저장까지 전부 롤백해야할까?
- 서비스들이 너무 강하게 연결된 것 아닐까? (coupling 문제)
하지만 GFS라던가 DDIA등을 읽어본 우리들은 로깅을 통해 이런 상황을 해결할 수 있다는 것을 본 적이 있다. 어떤 다른 저장소에 트랜잭션같은 정보를 저장해두고, 이를 각 서비스가 필요할 때 읽도록 하면 되지 않을까? 또한 그렇다면 과거 정보/이벤트를 다시 읽어서 처리하는것 또한 가능해질 것이다.
이를 재처리(Replay)라고 한다.
결국 하고싶은건, 거래가 발생했다는 사실을 독립적으로 보관하고, 필요한 서비스들이 각자의 속도로 읽게 하는 것 Kafka는 이런 이벤트 흐름을 다루기 위해 만들어진 분산 이벤트 스트리밍 플랫폼 이다.
2. Kafka 기본 용어
이제 카프카를 언제 쓰는지 어렴풋이 알았으니, 위 예시에 맞춰 구체적인 용어들을 알아보자. 거래 발생을 예시로 들거고, 각 필드의 뜻은 아래와 같다.
| 필드 | 의미 |
|---|---|
event_id | 거래 이벤트의 고유 식별자 |
account_id | 거래가 발생한 계좌 ID |
Record / 레코드
Kafka가 다루는 가장 작은 데이터 단위
예를 들면 다음과 같겠다.
{
  "event_id": "e-001",
  "account_id": "acct-001"
}
그냥 뭐.. 1번 계좌가 1번 이벤트 발생시킨 간단한 상황만 신경써보자.
Topic / 토픽
데이터가 모이는 논리적 공간
우리가 저장할 데이터는 하나만 있지 않다. 예를들어, 거래 발생이벤트인 trades.raw, 사용자 가입 이벤트인 user.registered 등이 있을 수 있다. 이 각각을 Topic이라 한다.
- DB의 테이블이랑 비슷한 느낌이라고 생각하면 좋을듯
Partition / 파티션
하나의 Topic을 나누는 단위
초당 수십만건의 이벤트가 발생한다고 하면, 모든 이벤트를 순서대로 처리하는 방식은 병목이 될 수 있다. 대신 이를 Partition으로 나누어서 데이터를 분산 저장하고 여러 consumer이 병렬로 처리하도록 할 수 있다.
Kafka는 Topic 전체의 메세지 순서는 보장하지 않지만, 각 Partition 내부에서의 순서는 보장한다.
Key / 키
Partition 혹은 Record를 구분할 때 사용하는 값
Kafka Record는 Key-Value를 넣을 수 있다.
key   = acct-001
value = {"event_id":"e-001","account_id":"acct-001"}
어떤 Record를 각 Partition으로 보낼 때, 기본적으로는 GFS에서 했던것과 같이 key를 해싱한값을 기반으로 한다. 따라서 순서를 보장하고 싶은 데이터가 있다면 해당 데이터들은 같은 파티션 안에 들어갈 수 있도록 해야한다.
- 파이썬의 dict나 cpp의 set같은 느낌이 아니다!
- 같은 key의 데이터가 여러개 있어도 된다.
예를 들어 위와 같은 상황에 key값을 event_id로 한 상황과 account_id로 한 상황 두가지를 생각해보자.
- 만약
account_id로 했다면 같은 계좌는 같은 key를 가지므로 같은 Partition 안에 들어가게 되고, 각 계좌에 대한 이벤트는 기록된 순서가 보장된다. - 하지만
event_id를 key로 했다면 같은 계좌가 다른 Partition에 들어가는 일이 생기고, Topic 단위에서는 순서를 보장하지 않기에 순서가 깨질 수 있다.
Offset / 오프셋
Partition 내부에서 Record를 가리키는 위치
별건 아니고 Partition에 데이터가 들어오면 그게 offset 0, 1, 2… 하고 저장될 뿐이다 이는 위에서 각 consumer / 서비스별로 어디까지 읽었는지를 저장해야하니까. Consumer은 이를 기준으로 어느 위치부터 읽을지를 결정하며, Consumer Group별로 다음에 읽을 위치를 Committed Offset으로 기록할 수 있다.
Producer / Broker / Consumer
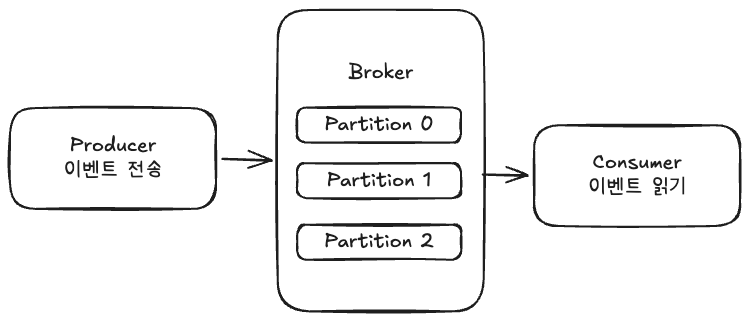
- Producer: 이벤트를 Kafka에 전송하는 프로그램
- Broker: Kafka 서버 / 이벤트 저장과 클라이언트의 읽기, 쓰기 요청 처리
- Consumer: Kafka에 저장된 이벤트를 읽어 처리하는 프로그램
03. 실습
카프카 키기
도커는 깔려있다고 믿겠다.
docker run -d \
  --name de-w01-kafka \
  -p 127.0.0.1:9092:9092 \
  apache/kafka:4.3.1
Topic 생성
docker exec de-w01-kafka \
  /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 $(: 접속할 Kafka Broker 주소) \
  --create $(: 토픽을 만들건데) \
  --topic trades.raw $(: 토픽의 이름은 trades.raw고) \
  --partitions 3 $(: Partition은 3개로 할건데) \
  --replication-factor 1 $(: 각 Partition의 복제는 1개로 유지하겠다)
참고로 현재 Broker이 한개라서 replication factor은 1밖에 못한다.
Topic 조회
docker exec de-w01-kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 \
  --describe $(: Topic의 구성 정보 조회) \
  --topic trades.raw
아마 대충 이런식으로 나올 것이다.
Topic: trades.raw  PartitionCount: 3  ReplicationFactor: 1

Partition: 0  Leader: 1  Replicas: 1  Isr: 1
Partition: 1  Leader: 1  Replicas: 1  Isr: 1
Partition: 2  Leader: 1  Replicas: 1  Isr: 1
- Leader: 해당 Partition의 읽기-쓰기 요청을 주로 담당하는 Broker
- Replicas: 해당 Partition의 복제본이 배치된 Broker 목록
- Isr: 복제본 중 Leader와 충분히 동기화된 것으로 인정되는 집합 (In-Sync Replicas)
Consumer / Producer 실행
이제 Broker이 잘 만들어져있으니, Consumer과 Produser을 연결하자.
docker exec -it de-w01-kafka $(: -i : stdin 열어두기 / -t : 가상터미널 할당) \
  /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 \
  --topic trades.raw \
  --from-beginning $(: 유효한 committed offset이 없으면 가장 오래된 Record 읽기) \
  --group w01-cli $(: Consumer Group ID 지정) \
  --formatter-property print.key=true \
  --formatter-property print.partition=true \
  --formatter-property print.offset=true
아래 세개는 각각 Record의 Key / Partition 번호 / Offset을 출력하라는 뜻이다. 이렇게 Consumer를 켜두고, 다른 터미널에서 다음을 실행하자.
docker exec -it de-w01-kafka \
  /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server localhost:9092 \
  --topic trades.raw \
  --property parse.key=true $(: 입력 문자열에서 key를 분리할건데) \
  --property key.separator=: $(: 그 separator는 ":"이다)
위를 예를 들자면 acct-001:{"event_id":"e-001"}는
Key   = acct-001
Value = {"event_id":"e-001"}
로 해석된다는 뜻이다.
아무튼 Producer창에 아래 내용을 붙여넣어보자.
acct-001:{"event_id":"e-001","account_id":"acct-001"}
acct-002:{"event_id":"e-002","account_id":"acct-002"}
acct-001:{"event_id":"e-003","account_id":"acct-001"}
Consumer을 보면 데이터가 잘 들어온것을 볼 수 있다.
Partition:0	Offset:0	acct-002	{"event_id":"e-002","account_id":"acct-002"}
Partition:1	Offset:0	acct-001	{"event_id":"e-001","account_id":"acct-001"}
Partition:1	Offset:1	acct-001	{"event_id":"e-003","account_id":"acct-001"}
같은 key는 같은 Partition에 할당된것도 잘 보인다!
Consumer Group과 재실행
다음 두 명령어를 실행해보자.
docker exec -it de-w01-kafka \
  /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 \
  --topic trades.raw \
  --from-beginning \
  --group w01-cli \
  --timeout-ms 5000 # 5초동안 새 메세지를 못받으면 Consumer 종료
docker exec -it de-w01-kafka \
  /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 \
  --topic trades.raw \
  --from-beginning \
  --group w01-replay $(: 아까랑 다른 group이다! ) \
  --timeout-ms 10000 \
  --formatter-property print.key=true \
  --formatter-property print.partition=true \
  --formatter-property print.offset=true
위에서는 아까랑 같은 group이고, 아래에서는 아까랑 다른 group이다 그래서 위 명령어에서는 아까 읽은게 저장되어서 committed offset에 저장되어있을테니, 새로운걸 안읽고 아래 명령어에서는 committed offset이 없으니 아까 데이터를 다시 받는 것을 알 수 있다.
그리고 이걸 볼 때, committed offset은 Broker이 저장한다는 것을 알아낼 수 있다.
Broker 재시작
docker stop de-w01-kafka
docker start de-w01-kafka
docker exec -it de-w01-kafka \
  /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 \
  --topic trades.raw \
  --from-beginning \
  --group w01-after-restart \
  --timeout-ms 10000 \
  --formatter-property print.key=true \
  --formatter-property print.partition=true \
  --formatter-property print.offset=true
Kafka는 기본적으로 Record를 디스크의 로그에 저장하기때문에, 프로세스를 정상 종료해도 보존기간 내의 데이터는 유지됨을 알 수 있다.
04. 정리
간단하게 Kafka의 탄생 배경을 알아보고 가벼운 실습까지 진행했다. 뒷 글에서 조금 더 괴롭혀보자.